
GPU·네트워크·작업 정보 통합해 장애 원인과 영향 추적
IREN 운영에 활용…IBM·Tesla 등도 도입 계획
핵심 요약
- NVIDIA는 10월 22일 AI 팩토리의 장애 징후를 조기에 파악하는 AIOps 플랫폼 Minerva를 출시했다고 밝혔다.
- NVIDIA의 10월 22일 발표에 따르면 Minerva는 시간당 수십억 개 데이터 포인트를 분석하며, 수십만 개 GPU 규모에서도 작업 지연에 영향을 주는 부품을 추적할 수 있다.
NVIDIA는 10월 22일 AI 팩토리의 장애 징후를 조기에 파악하고 운영 생산성을 높이기 위한 AIOps 플랫폼 Minerva를 출시했다고 밝혔다.
AI 팩토리는 고속 네트워크로 연결한 다수의 GPU로 모델을 학습하고 AI 애플리케이션을 구동하는 운영 환경이다. 대규모 환경에서는 부품 하나의 성능 저하가 작업 전체를 지연시킬 수 있다.
Denis Skrinnikoff IREN 최고기술책임자(CTO)는 “NVIDIA Minerva는 우리 운영팀에 네트워크와 GPU, 그 위에서 실행되는 작업을 아우르는 하나의 뷰를 제공해, 문제 해결보다 사전 유지보수에 더 집중할 수 있게 한다”고 말했다.
IREN은 AI 팩토리 최적화에 Minerva를 활용하고 있다. Aolani, Bitdeer AI, IBM, Jio, Lambda, Quake AI, Tesla도 Minerva를 도입할 계획이다. Dell Technologies와 Lenovo, Supermicro는 AI 팩토리 운영 포트폴리오의 일부로 Minerva를 제공할 예정이라고 NVIDIA는 밝혔다.
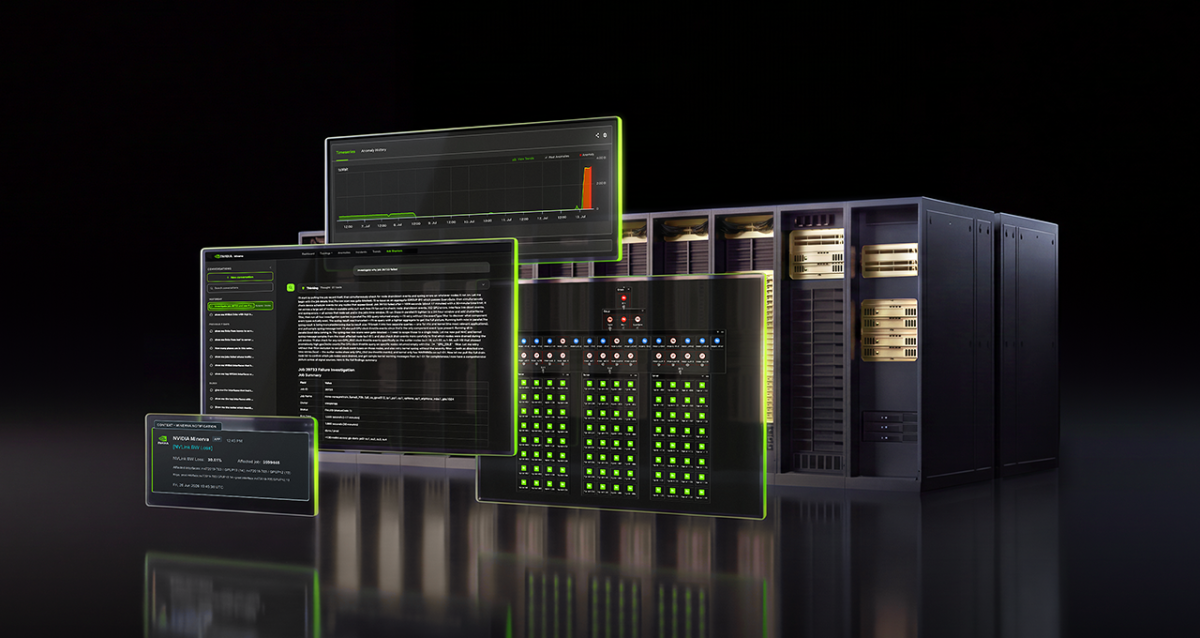
Minerva는 GPU와 네트워크, 스토리지, 스케줄러, 워크로드에서 수집한 원격 측정 데이터를 통합한다. GPU·SuperNIC·스위치·케이블과 실행 중인 작업의 관계를 동적 지식 그래프로 구성해, 수십만 개 GPU로 이뤄진 AI 팩토리에서도 느려진 학습 작업에 영향을 주는 부품을 추적할 수 있다.
Minerva는 지도·비지도 머신러닝으로 시간당 수십억 개 데이터 포인트를 분석한다. NVIDIA는 Minerva가 정상 동작을 학습해 이전에 관측하지 못한 이상을 탐지하고, 발생 조짐을 보이는 장애를 예측하며, 인프라 연결 구조를 바탕으로 관련 사건을 연계한다고 설명했다.
운영자는 Minerva에 내장된 AI 어시스턴트와 외부 에이전트형 AI 도구를 통해 실시간 원격 측정 데이터에 기반한 자연어 인터페이스를 이용할 수 있다. Minerva는 대화로 클러스터 상태를 조사하고 복구 방안을 권고하는 기능을 제공한다. 운영팀은 사람이 직접 수정 조치를 수행하도록 하거나 인프라 API와 외부 시스템을 통해 Minerva를 자동화에 연결하는 방식을 선택할 수 있다.
NVIDIA는 Minerva가 관련 경보를 추정 근본 원인과 함께 하나의 대응 가능한 사건으로 묶어, 개별 증상을 일일이 확인하는 부담을 줄인다고 밝혔다. 작업과 인프라 문제를 함께 분석해 사후 대응에서 사전 유지보수로 전환하고, 장애 없이 작업을 실행하는 시간을 늘리며 복구 시간을 단축하도록 돕는다는 설명이다.
Minerva가 초점을 맞춘 AI 팩토리 생산성은 GPU 사용 시간, 유효 처리량(goodput), 클러스터 가동 시간, 토큰 생산량을 통해 인프라가 수행한 유용한 작업을 측정하는 지표다. NVIDIA는 다른 GPU보다 높은 온도나 부하가 걸릴 때 나타나는 NVMe 드라이브의 성능 저하처럼 놓치기 쉬운 징후를 찾아 GPU 가동 시간을 늘리는 데 Minerva를 활용할 수 있다고 설명했다.
