
Terminal-Bench 4.0 과제 해결률 50.3%, 전작보다 두 배 이상 높아
핵심 요약
- 오픈AI가 컴퓨터 사용과 시각 추론을 강화한 GPT-6.1 테라를 공개했다. 표준 API 가격은 전작보다 50% 낮췄으며 챗GPT 워크·코덱스와 API에서 이용할 수 있다.
오픈AI가 업무 특화 AI 모델 GPT-6.1 테라(GPT-6.1 Terra)를 10월 26일(현지시간) 공개했다. 컴퓨터 사용과 시각 추론, 코딩 능력을 높이면서 표준 API 가격을 GPT-5.6 테라와 GPT-6.1 솔보다 50% 낮췄다.
표준 API 요금은 토큰 100만 개당 입력 1달러, 캐시된 입력 0.05달러, 출력 5달러다. 개발자는 'gpt-6.1-terra'를 선택해 사용할 수 있다. 챗GPT 워크(ChatGPT Work)와 코덱스(Codex)의 플러스(Plus), 프로(Pro), 엔터프라이즈(Enterprise), 에듀(Edu) 이용자에게도 제공된다. 두 서비스에서 같은 사용량으로 처리하는 작업은 GPT-5.6 테라보다 늘었으며, GPT-6.1 솔과 GPT-6 아스트라 대비 증가 폭도 크다.
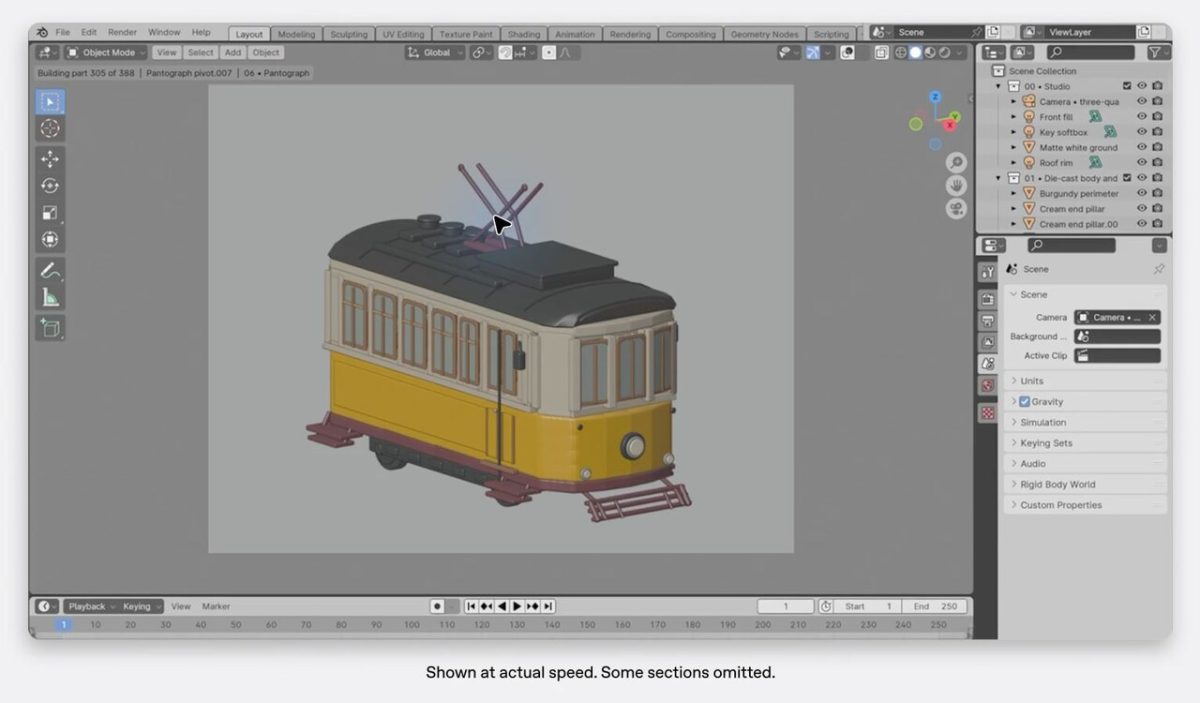
시각 정보 이해와 컴퓨터 조작, 글쓰기 능력을 결합해 제안서 작성, 기술 도면 해석, 양식 입력, 영상 편집 등을 처리한다. 오픈AI에 따르면 전문 업무 평가인 'Agents' Last Exam'에서 중간 추론 설정 점수는 GPT-5.6 테라보다 15%포인트 높았고 작업 비용은 약 3분의 1이었다. 이 평가에는 건축 도면의 3D 모델 변환과 애니메이션 복원용 타임코드 기록 작성 등이 포함됐다. GPT-6 아스트라와는 비슷한 성능을 내면서 토큰당 가격은 10분의 1 수준이었다.
같은 평가의 최대 추론 설정에서는 클로드 오퍼스 5.5(Claude Opus 5.5)보다 토큰 효율성이 3배 이상 높았고, 토큰당 가격은 4분의 1, 작업당 비용은 약 9분의 1 수준이었다. 시각 추론 평가 MMMU-Pro에서는 모든 추론 설정에서 GPT-5.6 테라를 앞섰다. 데스크톱 다단계 작업 평가 OSWorld 2.1에서도 중간 추론 설정으로 전작의 기존 최고 점수를 넘고 작업당 비용을 낮췄다.
코딩 에이전트의 명령줄 문제 해결 능력을 측정하는 Terminal-Bench 4.0에서는 최대 추론 설정 과제 해결률이 50.3%로, GPT-5.6 테라의 공개 점수 21.5%보다 두 배 이상 높았다. 과학 연구의 코드 활용 능력을 평가하는 Terminal-Bench-Science 0.1에서도 더 낮은 비용으로 GPT-6.1 솔을 앞섰다. 다만 오픈AI는 가장 복잡한 소프트웨어 개발에는 GPT-6.1 솔과 GPT-6 아스트라가 여전히 더 적합하다고 밝혔다.
사실 오류를 유도하는 오픈AI 자체 평가에서 낮은 추론 설정의 오류율은 16.7%로, 전작의 53.6%보다 약 37%포인트 낮았다. 최대 추론 설정에서는 4.3%로 전작보다 18%포인트 개선돼 GPT-6 아스트라와 GPT-6.1 솔에 가까운 정확도를 보였다.
GPT-6.1 테라는 오픈AI의 AI 위험 평가 체계인 '준비태세 프레임워크(Preparedness Framework)'에서 사이버보안 역량의 '중대(Critical)' 기준에 도달했으며 GPT-6 아스트라의 안전장치를 유지한다. 오픈AI는 사용자 요청 범위 안에서 작업하고 한계와 진행 장애 요인을 알리는 능력도 개선했다고 설명했다. 사용자 지시를 무시하도록 유도하는 악성 프롬프트 인젝션에 대한 저항성은 자체 시험에서 확인했다.
